①Agentic AI时代数据中心CPU与GPU的配比将逐步提升至1:1,部分复杂智能体场景甚至需要更高的CPU密度;
②Intel 18A已经进入量产阶段,其高性能版本Intel 18A-P目前也已进入风险试产阶段。14A面向内部产品的风险试产计划于2027年下半年启动;
《科创板日报》9月23日讯(记者 陈俊清) 传统AI训练与推理场景中,GPU与CPU的资源需求比例约为8:1。随着Agentic AI工作流爆发,AI负载从单一模型推理转向复杂任务执行,这一经典配比正发生变化。
在近日举行的2026英特尔技术创新与产业生态大会上,英特尔多次发表观点称,Agentic AI时代数据中心CPU与GPU的配比将逐步提升至1:1,部分复杂智能体场景甚至需要更高的CPU密度。
与会业内专家普遍认为,智能体AI从对话生成转向完成任务的转变,带来了任务编排复杂度提升、工具调用异构化、时序逻辑处理激增等多重变化,将持续推高AI集群中CPU的配置权重。
“当前全行业面临AI算力全面短缺,CPU、GPU、存储三大核心资源均处于紧缺状态。”英特尔数据中心集团副总裁、中国区总经理陈葆立在接受《科创板日报》记者采访时表示,“目前Intel 18A量产情况顺利,希望能够利用新产能解决供应的问题。”
▍CPU与GPU配比趋向1:1
目前,多家统计机构已勾勒出AI智能体产业的增长空间。IDC预测,到2026年底,超过80%的企业应用将嵌入至少一个AI智能体;2031年,中国企业场景中的活跃智能体数量将达到3.5亿个。当前国内大模型每日Token调用量已增至2024年初的5000倍。
基础设施投资层面,Gartner数据显示,2026年全球AI优化型IaaS支出预计增长96%;美银证券预测,到2029年,中国AI数据中心的固定资产投资规模将超过2.2万亿元。
英特尔数据中心集团副总裁、中国区总经理陈葆立表示,数据中心AI负载占比预计将从2025年的40%提升至2030年的80%,驱动整个数据中心架构发生变革。英特尔副总裁兼端侧计算和物理AI事业部中国区总经理高嵩表示,驱动这场AI智能革命的,有两大核心驱动力,分别是规模定律和密度定律。“一个90亿参数的新模型,其智能程度已经达到、甚至超过了几个月前1200亿参数的大模型。”
英特尔首席营销与传播官Annie Shea Weckesser介绍英特尔的三点战略,首先,是覆盖PC、边缘和数据中心的开放计算平台;其次,是围绕特定工作负载设计的定制化芯片;第三,是在英特尔产品中实现日益复杂系统集成的制程与封装技术。
在数据中心与AI基础设施方面,随着CPU在AI算力中的权重提升,CPU整机柜正在从选配变成标配,但行业面临标准不统一、软硬件适配门槛高、采购成本高的痛点,这也是x86架构在AI时代变得重要的原因。Annie Shea Weckesser表示,“我们预估,到2030年,全球超过80%的服务器都将运行在x86架构之上。”
同时,AI正在推动各类产品对更强计算能力和更高能效提出更高要求,制程技术仍然是满足这一需求的关键。Annie Shea Weckesser表示,Intel 18A系列正在为下一代英特尔产品打造技术基础。Intel 18A已经进入量产阶段,其高性能版本Intel 18A-P目前也已进入风险试产阶段。Intel 14A进展顺利。面向内部产品的风险试产计划于2027年下半年启动,并以2028年实现大规模量产爬坡为目标。
▍CPU与GPU进入深度协同新纪元
基于对智能体时代算力需求的判断,陈葆立提出AI 工厂架构理念,他将未来数据中心划分为三类协同的服务器集群:一是 CPU 服务器集群,负责 AI 智能体的执行与工作编排;二是 GPU 智算集群,配备 AI 加速卡,承担模型推理与训练等算力密集型任务,即传统意义上的 “Token 工厂”;三是高性能存储集群,承载长对话记录、文档、合同、模型检查点等海量新增数据。
“这三类集群有一个非常重要的共同点 —— 都需要 CPU 来做数据调度。” 陈葆立认为,“AI 工厂” 不再以单纯的 Token 产出为衡量标准,而是转向以任务为导向,通过系统级协同优化,实现更低资源消耗、更高运行效率,完成更复杂的工作。
作为云厂商的代表,阿里云是中国首家基于英特尔至强6处理器推出公有云服务的云厂商。目前,阿里云已推出超过117种基于至强6的云实例类型。
阿里云首席云服务器架构师陈剑将AI算力的发展划分为三个时代,而智能体的爆发正引领行业进入第三个范式周期。
“2012年之前是传统机器学习时代;2012年之后进入深度学习时代,GPU成为绝对的算力中心;而从 2025 年开始,正式进入Agentic AI时代,智能体为解决任务而生,需要任务拆解、编排调度、工具调用,这些工作高度依赖CPU,CPU 重新回到舞台中央。” 陈剑表示,智能体时代不是CPU取代 GPU,而是进入一个CPU与GPU深度协同的新纪元。
在陈剑看来,智能体自身的发展也经历了四个阶段的快速迭代,而每一次进阶都在持续推高CPU的算力权重:
第一阶段是提示词驱动,核心是通过 Prompt 定义智能体角色与输出格式,人的参与度高,CPU负载相对较轻;
第二阶段是上下文记忆阶段,通过记忆管理保存多轮对话上下文,自动组装历史信息,大幅提升任务执行效率,但权限获取、工具失效等边界问题仍需人工处理;
第三阶段是规则化流程阶段,通过预定义规则明确权限管控、异常处理等逻辑,让智能体具备标准化的问题解决能力,任务跑通率显著提升;
第四阶段是自主迭代阶段,智能体可以自动拆解任务、自主调用工具、自行处理异常并迭代优化,最终交付任务结果,人的因素从核心链路中逐步淡出,CPU的调度与计算需求随之达到峰值。
CPU的核心目标,是让GPU最大化地进行核心计算,产生价值。智能体时代究竟需要什么样的CPU?如何衡量一颗CPU的真实智能体承载能力?成为行业当下热议话题。
英特尔首席工程师侯志强在论坛发表智能体算力公式:每机柜实际可交付智能体数=理论每机柜智能体数×CPU调度有效性×资源平衡度×计算卸载效益。
他表示,衡量一颗CPU的真实智能体承载能力,核心看三个维度:调度有效性取决于缓存命中率,用以破解智能体间歇运行导致的指令换出时延问题;资源平衡度以内存容量为核心短板,决定真实并发上限;计算卸载效益依靠内置AI加速引擎释放通用算力,带来额外增益。面向智能体场景的合格CPU,需要在大缓存架构、并行处理能力、灵活内存扩展与内置专用加速器上协同优化,最终目标是最大化GPU的有效算力产出,实现智能体规模化落地的成本最优。
▍GPU整机柜、超节点集体亮相
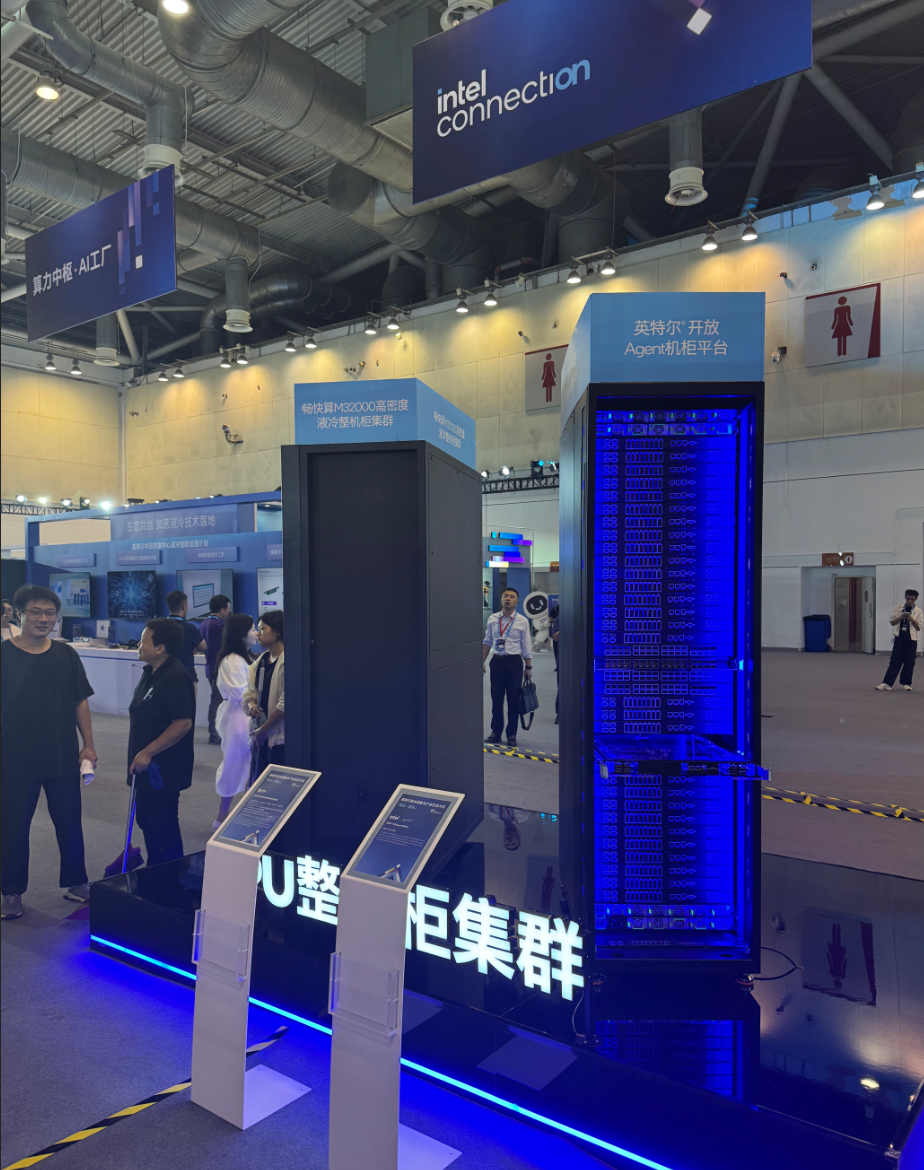
今年6月,英特尔推出Rack Scale Blueprint(机架级蓝图)计划,通过开放标准与合作伙伴共同开发机柜级AI基础设施方案,首批合作伙伴包括富士康和SambaNova。在本届英特尔技术及应用成果展区里,英特尔将多个GPU整机柜集群搬到了展台现场,包括畅快算M32000高密度液冷整机柜集群及其他多个基于英特尔开放Agent机柜平台建设的整机柜。
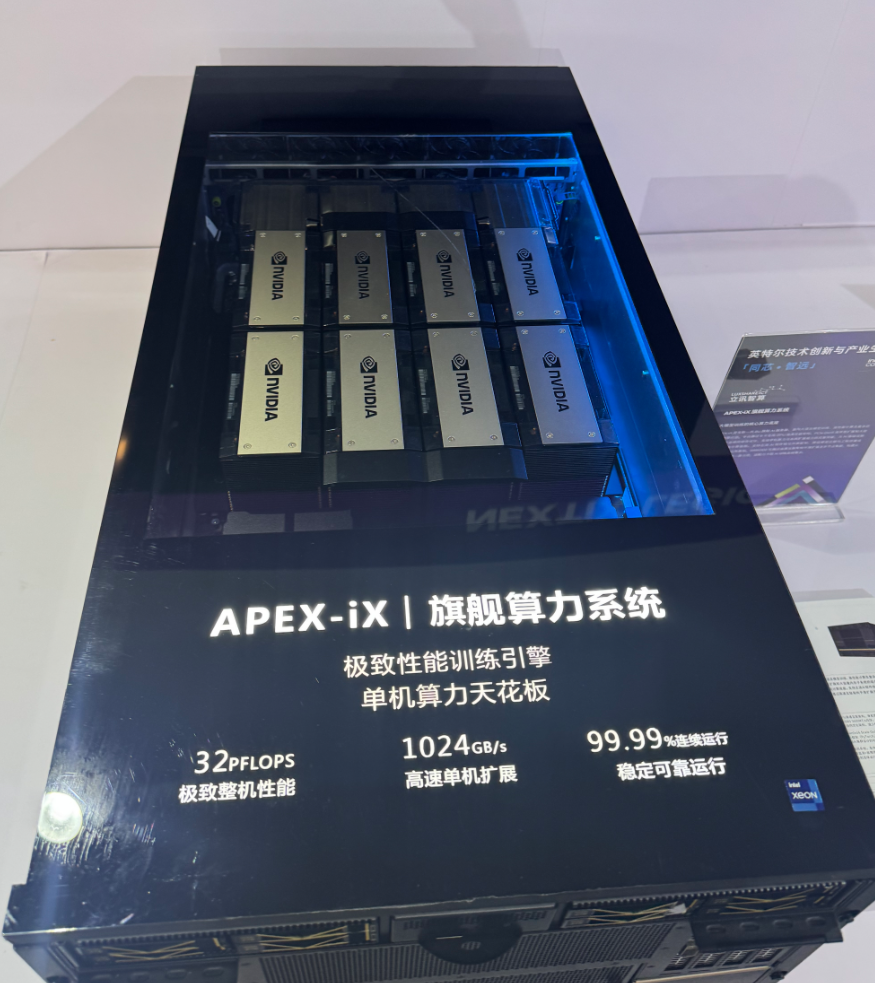
立讯智算在现场展示了NEXTiX LEGION产品家族。其中,企业级智算系统IRON-iX是新一代5U高密度异构算力平台,面向大语言模型训练、推理及企业级AI应用场景打造。现场工作人员表示,该系统兼容英特尔4代、5代、6代至强处理器,样机搭载沐曦曦云 C550 算力卡。
此外,该公司展示的TITAN-iX万卡集群是面向大模型训练与推理打造的新一代液冷整机柜 AI 集群解决方案。现场工作人员表示,TITAN-iX基于第四/五代英特尔至强可扩展处理器,单机柜支持128张GPU高密度部署,可扩展至千卡、万卡级集群。
富士康集团旗下,由谷歌、联发科持股的桦汉集团在展会现场展示了其八大边缘AI与边缘处理器行业解决方案,覆盖远洋航海、轨道交通、具身机器人等场景。现场工作人员表示,硬件平台层面,桦汉适配英特尔平台,从6代至15代。在全球市场布局上,桦汉集团采用多品牌分区运营模式:苏州桦汉负责中国大陆市场,台北桦汉覆盖中国台湾、日韩市场,德国团队承接欧美业务。
超节点作为机架级基建的核心技术方向,展区迎来了中兴通讯、H3C等厂商的多款产品。
中兴通讯的OEX超节点单机柜最大支持128GPU,CPU支持英特尔至强6性能核处理器,配多厂商主流GPU。据介绍,该机柜首创OEX正交无背板架构,并采用光交换与电交换融合组网方案,实现三零线缆设计,实现互联成本下降。
与此同时,H3C的Uni PoD S80000超节点、立讯智算的TITAN-iX AI超节点也在展台进行展示,其中,Uni PoD S80000基于英特尔至强6处理器AP系列打造,互联带宽可达400GB/S。立讯智算的TITAN-iX AI超节点使用第五代英特尔至强可扩展处理器作机头。
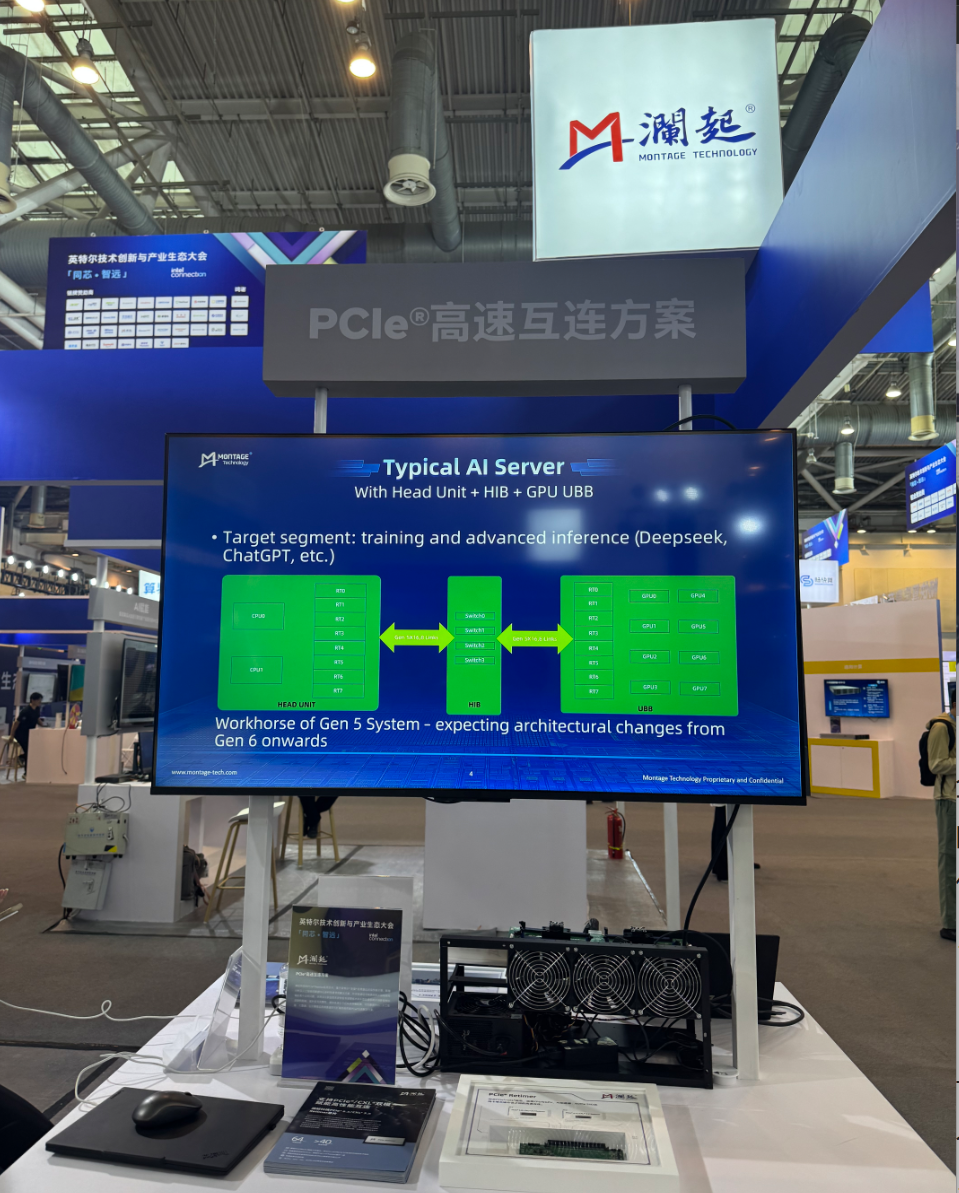
此外,科创板上市公司澜起科技展示了其CXL互连方案、PCle高速互连方案、服务器及加速卡时钟、津逮服务器平台等产品。CXL互连方案的核心是CXL内存扩展控制器(MXC)芯片。据了解,澜起科技CXL3.2MXC芯片已导入三星、SK海力士下一代CXL产品,预计2027年进入CXL规模商用元年。